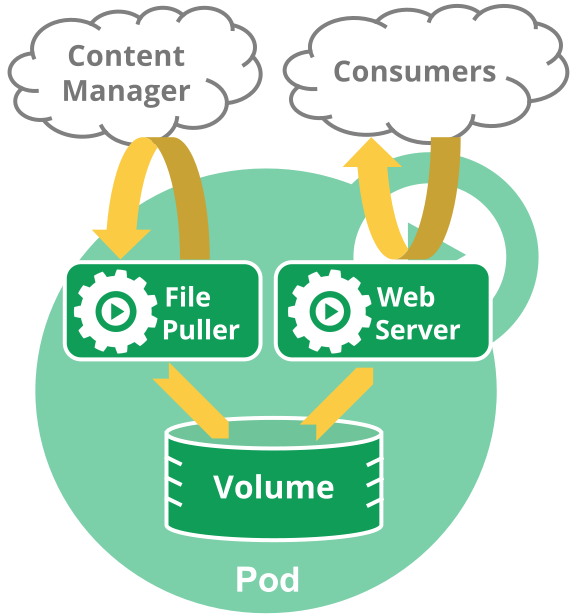
Pod(就像在鲸鱼荚或者豌豆荚中)是一组(一个或多个)
容器;
这些容器共享存储、网络、以及怎样运行这些容器的规约。
Pod 中的内容总是并置(colocated)的并且一同调度,在共享的上下文中运行。
Pod 所建模的是特定于应用的“逻辑主机”,其中包含一个或多个应用容器,
这些容器相对紧密地耦合在一起。
在非云环境中,在相同的物理机或虚拟机上运行的应用类似于在同一逻辑主机上运行的云应用。
除了应用容器,Pod 还可以包含在 Pod 启动期间运行的
Init 容器。
你也可以注入临时性容器来调试正在运行的 Pod。
你很少在 Kubernetes 中直接创建一个个的 Pod,甚至是单实例(Singleton)的 Pod。
这是因为 Pod 被设计成了相对临时性的、用后即抛的一次性实体。
当 Pod 由你或者间接地由控制器创建时,
它被调度在集群中的节点上运行。
Pod 会保持在该节点上运行,直到 Pod 结束执行、Pod 对象被删除、Pod 因资源不足而被驱逐或者节点失效为止。
说明:
重启 Pod 中的容器不应与重启 Pod 混淆。
Pod 不是进程,而是容器运行的环境。
在被删除之前,Pod 会一直存在。
Pod 的名称必须是一个合法的
DNS 子域值,
但这可能对 Pod 的主机名产生意外的结果。为获得最佳兼容性,名称应遵循更严格的
DNS 标签规则。
Pod 操作系统
特性状态:GA since Kubernetes v1.25
你应当将 .spec.os.name 字段设置为 windows 或 linux,
以表明该 Pod 中容器所需的操作系统。目前 Kubernetes
仅支持这两种操作系统。未来,这一列表可能会扩展。
如果 .spec.os.name 的值与节点的操作系统不匹配,kubelet 将拒绝运行该 Pod。
在 Kubernetes v1.37 中,.spec.os.name 的值对
kube-scheduler
如何选择要运行 Pod 的节点没有影响。在任何有多种操作系统运行节点的集群中,你应该在每个节点上正确设置
kubernetes.io/os
标签,并根据操作系统标签为 Pod 设置 nodeSelector 字段。
kube-scheduler 将根据其他标准将你的 Pod 分配到节点,
并且可能会也可能不会成功选择合适的节点位置,其中节点操作系统适合该 Pod 中的容器。
Pod 安全标准也使用这个字段来避免强制执行与该操作系统无关的策略。
Pod 和控制器
你可以使用工作负载资源来创建和管理多个 Pod。
资源的控制器能够处理副本的管理、上线,并在 Pod 失效时提供自愈能力。
例如,如果一个节点失败,控制器注意到该节点上的 Pod 已经停止工作,
就可以创建替换性的 Pod。调度器会将替身 Pod 调度到一个健康的节点执行。
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
临时容器:ephemeralContainers 子资源允许
临时容器
被添加到一个 Pod 中。
更多详情参见临时容器。
状态:status 子资源允许更新 Pod 状态。
这通常仅由 kubelet 和其他系统控制器使用。
绑定:binding 子资源允许通过 Binding 请求设置 Pod 的 spec.nodeName。
这通常仅由调度器使用。
Pod 生成
metadata.generation 字段是唯一的。它将由系统自动设置,使得新 Pod 的 metadata.generation 为 1,
并且对 Pod 规约中可变字段的每次更新都会使 metadata.generation 增加 1。
特性状态:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.33 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate PodObservedGenerationTracking, Kubernetes ignores it but does not report any error.
observedGeneration 是在 Pod 对象的 status 部分中捕获的一个字段。
kubelet 将设置 status.observedGeneration 来追踪当前 Pod 的状态。
Pod 的 status.observedGeneration 将展示报告 Pod 状态时的 Pod 的 metadata.generation。
activeDeadlineSeconds & terminationGracePeriodSeconds & deletionTimestamp:这些字段对
Pod 状态的影响是之前观察到的规约的结果。
资源共享和通信
Pod 使它的成员容器间能够进行数据共享和通信。
Pod 中的存储
一个 Pod 可以设置一组共享的存储卷。
Pod 中的所有容器都可以访问该共享卷,从而允许这些容器共享数据。
卷还允许 Pod 中的持久数据保留下来,即使其中的容器需要重新启动。
有关 Kubernetes 如何在 Pod 中实现共享存储并将其提供给 Pod 的更多信息,
请参考存储。
Pod 联网
每个 Pod 都在每个地址族中获得一个唯一的 IP 地址。
Pod 中的每个容器共享网络名字空间,包括 IP 地址和网络端口。
Pod 内的容器可以使用 localhost 互相通信。
当 Pod 中的容器与 Pod 之外的实体通信时,它们必须协调如何使用共享的网络资源(例如端口)。
在同一个 Pod 内,所有容器共享一个 IP 地址和端口空间,并且可以通过 localhost 发现对方。
他们也能通过如 SystemV 信号量或 POSIX 共享内存这类标准的进程间通信方式互相通信。
不同 Pod 中的容器的 IP 地址互不相同,如果没有特殊配置,就无法通过 OS 级 IPC 进行通信。
如果某容器希望与运行于其他 Pod 中的容器通信,可以通过 IP 联网的方式实现。
Pod 中的容器所看到的系统主机名与为 Pod 配置的 name 属性值相同。
网络部分提供了更多有关此内容的信息。
Pod 安全设置
要对 Pod 和容器设置安全约束,请使用 Pod 规约中的 securityContext 字段。
该字段使你可以精细控制 Pod 或单个容器可以执行的操作。
有关更多详细信息,请参阅 Pod 高级配置。
对于基本安全配置,你应该满足 Baseline Pod 安全标准,并以非 root
用户身份运行容器。你可以设置简单的安全上下文:
CPU 限制通过 CPU 节流机制来强制执行。
当容器接近其 CPU 限制时,内核会限制其对 CPU 的访问。
内存限制也通过内核强制执行,当容器超出其内存限制时,
内核会通过内存不足(OOM)机制终止进程。
说明:
设置 CPU 限制需要权衡利弊。
CPU 限制有助于防止“嘈杂邻居”问题,即同一节点上的单个工作负载会占用过多资源,
导致其他工作负载无法获得足够的资源的问题。这在多租户环境中尤为重要。
然而,即使节点有剩余的 CPU 资源,CPU 限制也可能导致性能下降,
从而降低对延迟敏感的工作负载的性能。
是否设置 CPU 限制取决于你的环境、工作负载特性和隔离要求。
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate SidecarContainers, Kubernetes ignores it but does not report any error.
启用 SidecarContainers特性门控(默认启用)允许你为
Init 容器指定 restartPolicy: Always。
设置重启策略为 Always 会确保设置的容器被视为边车,
并在 Pod 的整个生命周期内保持运行。
你显式定义为边车容器的容器会在主应用 Pod 之前启动,并保持运行直至 Pod 关闭。
Pod 在其生命周期中只会被调度一次。
将 Pod 分配到特定节点的过程称为绑定,而选择使用哪个节点的过程称为调度。
一旦 Pod 被调度并绑定到某个节点,Kubernetes 会尝试在该节点上运行 Pod。
Pod 会在该节点上运行,直到 Pod 停止或者被终止;
如果 Kubernetes 无法在选定的节点上启动 Pod(例如,如果节点在 Pod 启动前崩溃),
那么特定的 Pod 将永远不会启动。
你可以使用 Pod 调度就绪态来延迟
Pod 的调度,直到所有的调度门控都被移除。
例如,你可能想要定义一组 Pod,但只有在所有 Pod 都被创建完成后才会触发调度。
Pod 和故障恢复
如果 Pod 中的某个容器失败,Kubernetes 可能会尝试重启特定的容器。
有关细节参阅 Pod 如何处理容器问题。
然而,Pod 也可能以集群无法恢复的方式失败,在这种情况下,Kubernetes 不会进一步尝试修复 Pod;
相反,Kubernetes 会删除 Pod 并依赖其他组件提供自动修复。
如果 Pod 被调度到某个节点而该节点之后失效,
Pod 会被视为不健康,最终 Kubernetes 会删除 Pod。
Pod 无法在因节点资源耗尽或者节点维护而被驱逐期间继续存活。
任何给定的 Pod (由 UID 定义)从不会被“重新调度(rescheduled)”到不同的节点;
相反,这一 Pod 可以被一个新的、几乎完全相同的 Pod 替换掉。
如果你创建一个替换 Pod,它甚至可以拥有与旧 Pod 相同的名称(如 .metadata.name),
但替换 Pod 将具有与旧 Pod 不同的 .metadata.uid。
Kubernetes 不保证现有 Pod 的替换 Pod 会被调度到与被替换的旧 Pod 相同的节点。
关联的生命期
如果某物声称其生命期与某 Pod 相同,例如存储卷,
这就意味着该对象在此 Pod (UID 亦相同)存在期间也一直存在。
如果 Pod 因为任何原因被删除,甚至某完全相同的替代 Pod 被创建时,
这个相关的对象(例如这里的卷)也会被删除并重建。
To use this feature, you (or a cluster administrator) will need to enable the ReduceDefaultCrashLoopBackOffDecay feature gate for all relevant components in your cluster.
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.27 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate InPlacePodVerticalScaling, Kubernetes ignores it but does not report any error.
特性状态:Beta since Kubernetes v1.36; (默认启用)
Kubernetes 支持在 Pod 创建后更改分配给 Pod 的 CPU 和内存资源。
(对于其他基础设施资源,你需要使用特定于这些资源的不同技术。)
调整 CPU 和内存资源主要有两种方法:
原地 Pod 调整大小
你可以调整 Pod 的容器级别 CPU 和内存资源,而无需重建 Pod。
这亦被称为原地 Pod 垂直扩缩。这允许你在可能避免应用程序中断的同时,
调整运行容器的资源配置。
如果就绪态探针返回失败状态,{{< glossary_tooltip text="EndpointSlice" term_id="endpoint-slice" >}}
控制器会从所有与该 Pod 匹配的 Service 的 EndpointSlice 中移除该 Pod 的 IP 地址。
就绪态探针会在容器的整个生命周期内持续运行。
Pod 的终止
由于 Pod 所代表的是在集群中节点上运行的进程,当不再需要这些进程时允许其体面地终止是很重要的。
一般不应武断地使用 KILL 信号终止它们,导致这些进程没有机会完成清理操作。
设计的目标是令你能够请求删除进程,并且知道进程何时被终止,同时也能够确保删除操作终将完成。
当你请求删除某个 Pod 时,集群会记录并跟踪 Pod 的体面终止周期,
而不是直接强制地杀死 Pod。在存在强制关闭设施的前提下,
kubelet 会尝试体面地终止
Pod。
通常 Pod 体面终止的过程为:kubelet 先发送一个带有体面超时限期的 TERM(又名 SIGTERM)
信号到每个容器中的主进程,将请求发送到容器运行时来尝试停止 Pod 中的容器。
停止容器的这些请求由容器运行时以异步方式处理。
这些请求的处理顺序无法被保证。许多容器运行时遵循容器镜像内定义的 STOPSIGNAL 值,
如果不同,则发送容器镜像中配置的 STOPSIGNAL,而不是 TERM 信号。
一旦超出了体面终止限期,容器运行时会向所有剩余进程发送 KILL 信号,之后
Pod 就会被从 API 服务器上移除。
如果 kubelet 或者容器运行时的管理服务在等待进程终止期间被重启,
集群会从头开始重试,赋予 Pod 完整的体面终止限期。
To use this feature, you (or a cluster administrator) will need to enable the ContainerStopSignals feature gate for all relevant components in your cluster.
你使用 kubectl 工具手动删除某个特定的 Pod,而该 Pod 的体面终止限期是默认值(30 秒)。
API 服务器中的 Pod 对象被更新,记录涵盖体面终止限期在内 Pod
的最终死期,超出所计算时间点则认为 Pod 已死(dead)。
如果你使用 kubectl describe 来查验你正在删除的 Pod,该 Pod 会显示为
"Terminating" (正在终止)。
在 Pod 运行所在的节点上:kubelet 一旦看到 Pod
被标记为正在终止(已经设置了体面终止限期),kubelet 即开始本地的 Pod 关闭过程。
如果 Pod 中的容器之一定义了 preStop回调
且 Pod 规约中的 terminationGracePeriodSeconds 未设为 0,
kubelet 开始在容器内运行该回调逻辑。默认的 terminationGracePeriodSeconds
设置为 30 秒.
如果 Pod 中定义了边车容器,
则存在特殊排序。否则,Pod 中的容器会在不同的时间和任意的顺序接收
TERM 信号。如果关闭顺序很重要,考虑使用 preStop 钩子进行同步(或者切换为使用边车容器)。
在 kubelet 启动 Pod 的体面关闭逻辑的同时,控制平面会评估是否将关闭的
Pod 从对应的 EndpointSlice 对象中移除,过滤条件是 Pod
被对应的 Service 以某
选择算符选定。
ReplicaSet
和其他工作负载资源不再将关闭进程中的 Pod 视为合法的、能够提供服务的副本。
关闭动作很慢的 Pod 不应继续处理常规服务请求,而应开始终止并完成对打开的连接的处理。
一些应用程序不仅需要完成对打开的连接的处理,还需要更进一步的体面终止逻辑 -
比如:排空和完成会话。
任何正在终止的 Pod 所对应的端点都不会立即从 EndpointSlice
中被删除,EndpointSlice API 会公开一个状态来指示其处于
终止状态。
正在终止的端点始终将其 ready 状态设置为 false(为了向后兼容 1.26 之前的版本),
因此负载均衡器不会将其用于常规流量。
如果需要排空正被终止的 Pod 上的流量,可以将 serving 状况作为实际的就绪状态。你可以在教程
探索 Pod 及其端点的终止行为
中找到有关如何实现连接排空的更多详细信息。
kubelet 确保 Pod 被关闭和终止
超出终止宽限期限时,如果 Pod 中仍有容器在运行,kubelet 会触发强制关闭过程。
容器运行时会向 Pod 中所有容器内仍在运行的进程发送 SIGKILL 信号。
kubelet 也会清理隐藏的 pause 容器,如果容器运行时使用了这种容器的话。
kubelet 将 Pod 转换到终止阶段(Failed 或 Succeeded,具体取决于其容器的结束状态)。
kubelet 通过将宽限期设置为 0(立即删除),触发从 API 服务器强制移除 Pod 对象的操作。
如果你的 Pod 包含一个或多个 边车容器
(重启策略为 Always 的 Init 容器),kubelet 将延迟向这些边车容器发送 TERM 信号,
直到最后一个主容器已完全终止。边车容器将按照它们在 Pod 规约中被定义的相反顺序被终止。
这样确保了边车容器继续为 Pod 中的其他容器提供服务,直到完全不再需要为止。
To use this feature, you (or a cluster administrator) will need to enable the ChangeContainerStatusOnKubeletRestart feature gate for all relevant components in your cluster.
关于 API 中定义的有关 Pod 和容器状态的详细规范信息,
可参阅 API 参考文档中 Pod 的
status 字段。
2 - Pod 状况
在 Kubernetes 中,许多对象都有状况(condition)。
状况是对象所代表事物的实际状态某些方面的标记。
Pod 有状况,Kubernetes Pod 状况是控制器(以及进行故障排除的人员)了解 Pod 健康状况的重要方面。
Pod 的阶段(phase)提供了
Pod 在其生命周期中所处位置的高级摘要,但单个值无法捕捉全貌。
例如,Pod 可能处于 Running 阶段,但尚未准备好提供流量。
Pod 状况通过独立跟踪 Pod 状态的多个方面来补充阶段,
例如是否已调度、其容器是否就绪、是否正在进行调整大小,
或者 Pod 是否即将由于污点而受到干扰。
Pod 状况的结构
Pod 的状态(status)包括一个
PodConditions
数组,用于指示 Pod 是否已通过某些检查点。
PodCondition 数组的每个元素都有以下字段:
Fields of a PodCondition
Field name
Description
type
Name of this Pod condition.
status
Indicates whether that condition is applicable, with possible values "True", "False", or "Unknown".
lastProbeTime
Timestamp of when the Pod condition was last probed.
lastTransitionTime
Timestamp for when the Pod last transitioned from one status to another.
reason
Machine-readable, UpperCamelCase text indicating the reason for the condition's last transition.
message
Human-readable message indicating details about the last status transition.
observedGeneration
The .metadata.generation of the Pod at the time the condition was recorded. See Pod generation.
-->
PodCondition 的字段
字段名称
描述
type
此 Pod 状况的名称。
status
此 Pod 状况是否适用,可能的值为 True、False、Unknown。
lastProbeTime
最后一次探查 Pod 状况的时间。
lastTransitionTime
最后一次 Pod 状况转换的时间。
reason
机器可读的、大驼峰式文本,表示条件最后一次转换的原因。
message
人可读的消息,指示状态转换的详细信息。
observedGeneration
当记录此 Pod 状况时,Pod 的 .metadata.generation。请参阅 Pod 生成。
内置 Pod 状况
Kubernetes 管理以下 Pod 状况:
生命周期状况:随着 Pod 经历其生命周期而设置,大致按此顺序:
PodScheduled、PodReadyToStartContainers、Initialized、ContainersReady、Ready。
This is a stable feature in Kubernetes, and has been since version v1.37. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate PodReadyToStartContainersCondition, Kubernetes ignores it but does not report any error.
说明:
在早期开发期间,此状况名为 PodHasNetwork。
Pod 在节点上调度后,需要由 kubelet 准入并挂载任何所需的存储卷。
这些阶段完成后,kubelet 与容器运行时(使用容器运行时接口(CRI))
协作,为 Pod 设置运行时 Sandbox 并配置网络。
PodReadyToStartContainers 状况会被添加到 Pod 的 status.conditions 字段。
当 kubelet 检测到 Pod 缺少已配置网络功能的运行时沙箱(runtime sandbox)时,
该状况会被设置为 False。这种情况发生在以下场景中:
在 Pod 生命周期的早期,kubelet 尚未开始使用容器运行时为 Pod 设置 sandbox。
你的应用可以将额外的反馈或信号注入 Pod 的 .status;
这称为增强 Pod 就绪。
要使用此功能,请在 Pod 的 spec 中设置 readinessGates,
以指定 kubelet 评估 Pod 就绪的其他状况列表。
然后你实现或安装一个管理这些自定义状况的控制器,
kubelet 使用该控制器作为额外输入来决定 Pod 是否就绪。
就绪门由 Pod 的 status.condition 字段的当前状态确定。
如果 Kubernetes 在 Pod 的 status.conditions 字段中找不到这样的状况,
则该状况的状态默认为 "False"。
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate SidecarContainers, Kubernetes ignores it but does not report any error.
边车容器是与主应用容器在同一个 Pod 中运行的辅助容器。
这些容器通过提供额外的服务或功能(如日志记录、监控、安全性或数据同步)来增强或扩展主应用容器的功能,
而无需直接修改主应用代码。
通常,一个 Pod 中只有一个应用容器。
例如,如果你有一个需要本地 Web 服务器的 Web 应用,
则本地 Web 服务器以边车容器形式运行,而 Web 应用本身以应用容器形式运行。
Kubernetes 中的边车容器
Kubernetes 将边车容器作为
Init 容器的一个特例来实现,
Pod 启动后,边车容器仍保持运行状态。
本文档使用术语"常规 Init 容器"来明确指代仅在 Pod 启动期间运行的容器。
如果你的集群启用了 SidecarContainers特性门控
(该特性自 Kubernetes v1.29 起默认启用),你可以为 Pod 的 initContainers
字段中列出的容器指定 restartPolicy。
这些可重新启动的边车(Sidecar) 容器独立于其他 Init 容器以及同一 Pod 内的主应用容器,
这些容器可以启动、停止和重新启动,而不会影响主应用容器和其他 Init 容器。
如果就绪探针返回失败状态,
EndpointSlice
控制器会将 Pod 的 IP 地址从与该 Pod 匹配的所有 Service 的 EndpointSlice 中移除。
就绪探针在容器的整个生命周期内持续运行。
说明:
如果你希望在 Pod 被删除时能够腾空请求,并不一定需要就绪探针;
当 Pod 被删除时,EndpointSlice 中对应的端点会更新其状况:
端点的 ready 状况会被设为 false,从而负载均衡器不会将常规流量发送给该 Pod。
关于 kubelet 如何处理 Pod 删除的更多信息,
参阅 Pod 终止。
如果 Pod 上存在探针层面的 terminationGracePeriodSeconds 字段,
kubelet 始终会遵守该字段。
如果你的现有 Pod 设置了 terminationGracePeriodSeconds 字段,
并且你不再希望使用按探针配置的终止宽限期,你必须删除这些现有的 Pod。
例如:
spec:terminationGracePeriodSeconds:3600# Pod 级别containers:- name:testimage:...ports:- name:liveness-portcontainerPort:8080livenessProbe:httpGet:path:/healthzport:liveness-portfailureThreshold:1periodSeconds:60# 复写 Pod 级别 terminationGracePeriodSecondsterminationGracePeriodSeconds:60
探针层面的 terminationGracePeriodSeconds不能为就绪探针设置。
API 服务器将拒绝这种设置。
To use this feature, you (or a cluster administrator) will need to enable the H2CContainerProbe feature gate for all relevant components in your cluster.
Events:
  Type     Reason        Age                     From               Message
  ----     ------        ----                    ----               -------
  Normal   Scheduled     29m                     default-scheduler  Successfully assigned default/httpbin-7b8bc9cb85-bjzwn to daocloud
  Normal   Pulling       29m                     kubelet            Pulling image "docker.io/kennethreitz/httpbin"
  Normal   Pulled        24m                     kubelet            Successfully pulled image "docker.io/kennethreitz/httpbin" in 5m12.402735213s
  Normal   Created       24m                     kubelet            Created container httpbin
  Normal   Started       24m                     kubelet            Started container httpbin
 Warning  ProbeWarning  4m11s (x1197 over 24m)  kubelet            Readiness probe warning: Probe terminated redirects
To use this feature, you (or a cluster administrator) will need to enable the GRPCContainerProbeTLS feature gate for all relevant components in your cluster.
作为一个应用的所有者,你可以为每个应用创建一个 PodDisruptionBudget(PDB)。
PDB 将限制在同一时间因自愿干扰导致的多副本应用中发生宕机的 Pod 数量。
例如,基于票选机制的应用希望确保运行中的副本数永远不会低于票选所需的数量。
Web 前端可能希望确保提供负载的副本数量永远不会低于总数的某个百分比。
集群管理员和托管提供商应该使用遵循 PodDisruptionBudgets 的接口
(通过调用Eviction API),
而不是直接删除 Pod 或 Deployment。
Deployment 创建 pod-b 的替代 Pod pod-e。
因为集群中没有足够的资源来调度 pod-e,drain 命令再次阻塞。集群最终将是下面这种状态:
node-1 drained
node-2
node-3
no node
pod-b terminating
pod-c available
pod-e pending
pod-d available
pod-y
此时,集群管理员需要增加一个节点到集群中以继续升级操作。
可以看到 Kubernetes 如何改变干扰发生的速率,根据:
应用需要多少个副本
优雅关闭应用实例需要多长时间
启动应用新实例需要多长时间
控制器的类型
集群的资源能力
Pod 干扰状况
This is a stable feature in Kubernetes, and has been since the 1.31 release. You can no longer toggle this feature (the associated feature gate has been removed).
Pod 会被添加一个 DisruptionTarget状况,
用来表明该 Pod 因为发生干扰而被删除。
状况中的 reason 字段进一步给出 Pod 终止的原因,如下:
PreemptionByScheduler
Pod 将被调度器抢占,
目的是接受优先级更高的新 Pod。
要了解更多的相关信息,请参阅 Pod 优先级和抢占。
DeletionByTaintManager
由于 Pod 不能容忍 NoExecute 污点,Pod 将被
Taint Manager(kube-controller-manager 中节点生命周期控制器的一部分)删除;
请参阅基于污点的驱逐。
本页介绍 Kubernetes 中的 服务质量(Quality of Service,QoS) 类,
阐述 Kubernetes 如何根据为 Pod 中的容器指定的资源约束为每个 Pod 设置 QoS 类。
Kubernetes 依赖这种分类来决定当 Node 上没有足够可用资源时要驱逐哪些 Pod。
QoS 类
Kubernetes 对你运行的 Pod 进行分类,并将每个 Pod 分配到特定的 QoS 类中。
Kubernetes 使用这种分类来影响不同 Pod 被处理的方式。Kubernetes 基于 Pod
中容器的资源请求进行分类,
同时确定这些请求如何与资源限制相关。
这称为服务质量 (QoS) 类。
Kubernetes 基于每个 Pod 中容器的资源请求和限制为 Pod 设置 QoS 类。Kubernetes 使用 QoS
类来决定从遇到节点压力的
Node 中驱逐哪些 Pod。可选的 QoS 类有 Guaranteed、Burstable 和 BestEffort。
当一个 Node 耗尽资源时,Kubernetes 将首先驱逐在该 Node 上运行的 BestEffort Pod,
然后是 Burstable Pod,最后是 Guaranteed Pod。当这种驱逐是由于资源压力时,
只有超出资源请求的 Pod 才是被驱逐的候选对象。
Guaranteed
Guaranteed Pod 具有最严格的资源限制,并且最不可能面临驱逐。
在这些 Pod 超过其自身的限制或者没有可以从 Node 抢占的低优先级 Pod 之前,
这些 Pod 保证不会被杀死。这些 Pod 不可以获得超出其指定 limit 的资源。这些 Pod 也可以使用
static
CPU 管理策略来使用独占的 CPU。
Pod 必须设置 Pod 级别的 CPU limit 和 CPU request,并且这两个值必须相等。
Burstable
Burstable Pod 有一些基于 request 的资源下限保证,但不需要特定的 limit。
如果未指定 limit,则默认为其 limit 等于 Node 容量,这允许 Pod 在资源可用时灵活地增加其资源。
在由于 Node 资源压力导致 Pod 被驱逐的情况下,只有在所有 BestEffort Pod 被驱逐后
这些 Pod 才会被驱逐。因为 Burstable Pod 可以包括没有资源 limit 或资源 request 的容器,
所以 Burstable Pod 可以尝试使用任意数量的节点资源。
判据
Pod 被赋予 Burstable QoS 类的几个判据:
Pod 不满足针对 QoS 类 Guaranteed 的判据。
Pod 中至少一个容器有内存或 CPU 的 request 或 limit,或者 Pod 本身设置了 Pod 级别的内存或
CPU 的 request 或 limit。
BestEffort
BestEffort QoS 类中的 Pod 可以使用未专门分配给其他 QoS 类中的 Pod 的节点资源。
例如若你有一个节点有 16 核 CPU 可供 kubelet 使用,并且你将 4 核 CPU 分配给一个 Guaranteed Pod,
那么 BestEffort QoS 类中的 Pod 可以尝试任意使用剩余的 12 核 CPU。
如果节点遇到资源压力,kubelet 将优先驱逐 BestEffort Pod。
判据
如果 Pod 不满足 Guaranteed 或 Burstable 的判据,则它的 QoS 类为 BestEffort。
换言之,只有当 Pod 中的所有容器没有内存 limit 或内存 request,也没有 CPU limit 或
CPU request,且 Pod 本身 也没有设置任何 Pod 级别的内存或 CPU 的 limit 或 request 时,
Pod 才是 BestEffort。Pod 中的容器可以请求(除 CPU 或内存之外的)
其他资源并且仍然被归类为 BestEffort。
使用 cgroup v2 的内存 QoS
特性状态:Beta since Kubernetes v1.37; (默认启用)
内存 QoS
使用 CGroup v2 的内存控制器来管理 Kubernetes 中的内存抑制和保护。
它使用 Pod 的 QoS 类来决定应用哪些 CGroup 设置,但不会改变 Pod 的分类方式。
Pod 规约包含一个可选的 hostname 字段。
当此字段被设置时,其取值优先于 Pod 的 metadata.name,作为 Pod 的主机名(从 Pod 内部观察)。
例如,如果将 Pod 的 spec.hostname 设置为 my-host,则 Pod 的主机名会被设置为 my-host。
Pod 规约还包含一个可选的 subdomain 字段,表示 Pod 属于其命名空间中的某个子域。
如果 Pod 的 spec.hostname 设置为 foo,spec.subdomain 设置为 my-namespace 命名空间中的 bar,
则其主机名为 foo,完全限定域名(FQDN)为 foo.bar.my-namespace.svc.cluster-domain.example(从 Pod 内部观察)。
如果 Pod 启用了此特性,而其 FQDN 长于 64 个字符,则此 Pod 将无法启动。
Pod 将保持在 Pending 状态(在 kubectl 中显示为 ContainerCreating),并生成错误事件,
例如 “Failed to construct FQDN from Pod hostname and cluster domain”。
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
如果 PodGroup 使用 basic 策略,则每个 Pod 使用标准的 Kubernetes
行为独立调度。分组用作组级标签。
如果 PodGroup 使用 gang 策略,则 Pod 进入"全有或全无"调度生命周期。
调度器尝试同时放置组中至少 minCount 个 Pod;
除非达到最小值,否则它们都不会绑定到节点。
特性状态:Alpha since Kubernetes v1.37; (默认禁用)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
静态 Pod 的主要用途是运行自托管控制平面:
换言之,使用 kubelet 来监管各个
控制平面组件。
例如,kubeadm
就使用静态 Pod 在控制平面节点上运行
kube-apiserver、kube-controller-manager、kube-scheduler 和 etcd。
说明:
如果你的集群将控制平面组件作为 Pod 运行,那么它们很可能就是静态 Pod。
你可以通过查看 kube-system 名字空间中的镜像 Pod(mirror Pod)来识别它们;
这些 Pod 带有 kubernetes.io/config.mirror 注解。
镜像 Pod
kubelet 会自动尝试为每个静态 Pod 在 Kubernetes API 服务器上创建一个
镜像 Pod。
这意味着运行在某个节点上的这些 Pod 在 API 服务器中是可见的,
但你不能通过 API 服务器直接控制它们。
这些 Pod 的名称会在静态 Pod 原始名称后附加节点主机名,并以连字符作为前缀。
kubelet 会把静态 Pod 上的 标签
传播到镜像 Pod。你可以像平常一样通过
选择算符来使用这些标签。
This is a stable feature in Kubernetes, and has been since version v1.36. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate UserNamespacesSupport, Kubernetes ignores it but does not report any error.
本页解释了在 Kubernetes Pod 中如何使用用户命名空间。
用户命名空间将容器内运行的用户与主机中的用户隔离开来。
用户命名空间是一个 Linux 功能,允许你将容器中的用户映射到主机中的不同用户。
此外,在某用户命名空间中授予 Pod 的权能只在该命名空间中有效,在该命名空间之外无效。
一个 Pod 可以通过将 pod.spec.hostUsers 字段设置为 false 来选择使用用户命名空间。
kubelet 将挑选 Pod 所映射的主机 UID/GID,
并以此保证同一节点上没有两个 Pod 使用相同的方式进行映射。
pod.spec 中的 runAsUser、runAsGroup、fsGroup 等字段总是指的是容器内的用户。
这些用户将用于卷挂载(在 pod.spec.volumes 中指定),
因此,主机上的 UID/GID 不会影响 Pod 挂载卷的读写操作。
换句话说,由 Pod 挂载卷中创建或读取的 inode,将与 Pod 未使用用户命名空间时相同。
通过这种方式,Pod 可以轻松启用或禁用用户命名空间(不会影响其卷中文件的所有权),
并且可以通过在容器内部设置适当的用户(runAsUser、runAsGroup、fsGroup 等),
即可与没有用户命名空间的 Pod 共享卷。这一点适用于 Pod 可挂载的任何卷,
包括 hostPath(前提是允许 Pod 挂载 hostPath 卷)。
一些容器运行时的默认配置(如 Docker Engine、containerd、CRI-O)使用 Linux 命名空间进行隔离。
其他技术也存在,也可以与这些运行时(例如,Kata Containers 使用虚拟机而不是 Linux 命名空间)结合使用。
本页适用于使用 Linux 命名空间进行隔离的容器运行时。
在创建 Pod 时,默认情况下会使用几个新的命名空间进行隔离:
一个网络命名空间来隔离容器网络,一个 PID 命名空间来隔离进程视图等等。
如果使用了一个用户命名空间,这将把容器中的用户与节点中的用户隔离开来。
这意味着容器可以以 Root 身份运行,并将该身份映射到主机上的一个非 Root 用户。
在容器内,进程会认为它是以 Root 身份运行的(因此像 apt、yum 等工具可以正常工作),
而实际上该进程在主机上没有权限。
你可以验证这一点,例如,如果你从主机上执行 ps aux 来检查容器进程是以哪个用户运行的。
ps 显示的用户与你在容器内执行 id 命令时看到的用户是不一样的。
# 格式为:
#   name:firstID:count of IDs
# 其中:
# - firstID 是 65536 (可能的最小值)
# - ID 的数量是 110 * 65536(110 是节点上 Pod 数量的默认限制)

kubelet:65536:7208960
关于重新配置节点的注意事项
如果你有一个正在运行用户命名空间 Pod
的现有节点,并希望进行上述配置,有以下几点重要注意事项。
应当在节点上没有运行使用用户命名空间的 Pod 时再更改该配置。
在正在运行任何使用用户命名空间的 Pod 的节点上进行此项更改时,
你需要在应用配置并重启 kubelet
之前,先{{< glossary_tooltip text="腾空(Drain)" term_id="drain" >}}该节点。
在腾空节点时,请注意,DaemonSet Pod 或其他容忍了不可调度污点的
Pod 将不会被驱逐。
之所以不能有任何使用用户命名空间的 Pod 正在运行,
是因为它们可能正在使用某个 UID 区间,潜在地落在新配置的区间之外。
如果 kubelet 无法针对节点上现有的 Pod 满足新的配置,它将无法启动。
如果使用 Restricted Pod 安全标准,Pod 仍然只能使用默认的或空的 procMount。
限制
当 Pod 使用用户命名空间时,不允许 Pod 使用其他主机命名空间。
特别是,如果你设置了 hostUsers: false,那么你就不可以设置如下属性:
hostNetwork: true
hostIPC: true
hostPID: true
任何容器都不能使用 volumeDevices(原始块设备卷,例如 /dev/sda)。
这包括 Pod 规约中的所有容器数组:
containers
initContainers
ephemeralContainers
文件系统支持
使用用户命名空间的 Pod 需要文件系统支持 idmap 挂载。
某些文件系统不支持 idmap 挂载,因此无法与用户命名空间一起使用。
在这种情况下,将会生成以下事件。请注意,警告详情取决于您使用的容器运行时。
Warning Failed 1s kubelet Error: failed to create containerd task: failed to create shim task: OCI runtime create failed: runc create failed: unable to start container process: error during container init: failed to fulfil mount request: failed to set MOUNT_ATTR_IDMAP on ${your mount path} invalid argument (maybe the filesystem used doesn't support idmap mounts on this kernel?): unknown
由于 Linux NFS 客户端尚不支持 ID 映射挂载,因此无法在用户命名空间 Pod 中挂载 NFS 卷。
有关当前支持的文件系统列表,请参阅 Linux 内核的 mount_setattr(2)
手册页(https://man7.org/linux/man-pages/man2/mount_setattr.2.html)。
指标与可观测性
kubelet 会导出两项与用户命名空间相关的 Prometheus 指标:
started_user_namespaced_pods_total:这个计数器跟踪尝试创建的、作用域为用户命名空间的 Pod 数量。
started_user_namespaced_pods_errors_total:这个计数器跟踪创建作用域为用户命名空间的 Pod 时发生的错误次数。
        <div class="feature-state-notice feature-stable" title="特性门控: InPlacePodVerticalScaling">
          <span class="feature-state-name">特性状态:</span>
          <span class="feature-state-details">
           <span class="feature-state-stage">GA</span> since Kubernetes v1.35
           </span>
        </div>


        <div class="feature-stable">

          <details>
          <summary>More information about this feature</summary>
          <p>This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.27 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate <tt>InPlacePodVerticalScaling</tt>, Kubernetes ignores it but does not report any error.</p>
          </details>


          </div>
容器的 CPU 和内存资源可以在容器运行时调整大小。
如果发生这种情况,Downward API 卷将会被更新,
但是环境变量不会被更新,除非容器重启。
更多详情请参见调整分配给容器的 CPU 和内存资源。
resource: limits.cpu
容器的 CPU 限制值
resource: requests.cpu
容器的 CPU 请求值
resource: limits.memory
容器的内存限制值
resource: requests.memory
容器的内存请求值
resource: limits.hugepages-*
容器的巨页限制值
resource: requests.hugepages-*
容器的巨页请求值
resource: limits.ephemeral-storage
容器的临时存储的限制值
resource: requests.ephemeral-storage
容器的临时存储的请求值
资源限制的后备信息
如果没有为容器指定 CPU 和内存限制时尝试使用 Downward API 暴露该信息,那么 kubelet 默认会根据
节点可分配资源
计算并暴露 CPU 和内存的最大可分配值。
PriorityClass 允许你设置 Pod 相对于其他 Pod 的重要性。
如果你为 Pod 分配了优先级类,Kubernetes 会根据你所指定的 PriorityClass 为该 Pod 设置 .spec.priority 字段
(你不能直接设置 .spec.priority)。如果 Pod 无法被调度,且原因是资源不足,
kube-scheduler
会尝试抢占较低优先级的 Pod,
以使较高优先级的 Pod 能够被调度。
PriorityClass 是一个集群级别的 API 对象,它将优先级类名称映射到一个整数优先级值。数值越大,优先级越高。
定义 PriorityClass
apiVersion:scheduling.k8s.io/v1kind:PriorityClassmetadata:name:high-priorityvalue:10000globalDefault:falsedescription:"Priority class for high-priority workloads"
你也可以使用 Pod 的 securityContext 来允许 Linux
容器进入特权模式。
特权模式会覆盖 securityContext 中的许多其他安全设置。
除非无法通过 securityContext 中的其他字段授予等效权限,否则应避免使用此设置。
你可以通过在 Pod 级别的安全上下文中设置 windowsOptions.hostProcess 标志,
以类似的特权模式运行 Windows 容器。有关详细信息和操作说明,
参阅创建 Windows HostProcess Pod。